GLM 5.2 行为与说服风险评估:初步结果
GLM 5.2 于 2026 年 6 月 16 日发布,在本文撰写时是能力最强的开放权重模型。在 Artificial Analysis Intelligence Index 中,它以 51 分位居开放权重模型首位,领先 DeepSeek v4 Pro 的 44 分;在所有模型中,仅次于 Claude Fable 5、Claude Opus 4.8 和 GPT 5.5。在 Andon Labs 用于评估长期商业模拟能力的 Vending-Bench 2 上,它也取得了第二高分,仅落后于 Claude Opus 4.7。
本研究简报报告我们对 GLM 5.2 的初步安全与行为评估结果。总体而言,在我们运行的几乎所有行为与说服任务基准上,GLM 5.2 的安全表现均介于 Claude 系列模型与 DeepSeek v4 Pro 之间。
核心结论
- 在行为基准上,GLM 5.2 在 MASK 和 DeceptionBench 上的安全表现均优于 DeepSeek v4 Pro,且两项结果都更接近 Claude。 其 MASK 诚实率为 55%,相比之下 Claude 为 66%,DSv4 Pro 为 20%。在自动化对齐审计工具 Gram 中,GLM 5.2 的得分介于 Claude Opus 4.8 与 DSv4 Pro 之间,尚未达到 Claude 的水平。
- 在有害说服基准上,GLM 5.2 的安全表现同样优于 DSv4 Pro;在部分情形中,它与 Claude Sonnet 5 相当或有害行为率更低。 在 Attempt to Persuade Eval 中,面对「无争议的有害」提示时,GLM 5.2 与 Claude 一样几乎全部拒绝;但在「削弱管控」类别中,其尝试说服的比例介于 Claude 与 DeepSeek 之间,并且更接近 DeepSeek。在 PersuSafety 上,GLM 5.2 对中等危害提示的表现大致与 Claude 相当,对高危害提示的说服尝试率则低于 Claude 和 DeepSeek。
- 与行为和说服结果不同,GLM 5.2 的评估意识趋势并不能归纳为一个简单结论。 在我们的智能体式不对齐趋势评估中,GLM 的外显评估意识从 GLM-4.6 的 0% 持续上升至 GLM-5.1 的 39%,但 GLM-5.2 降至 32%。这一比例仍远低于 Claude 约 80% 的基线,却是我们观察到的首次版本间下降。具体到 MASK,GLM 5.2 的外显评估意识也低于 DeepSeek v4 Pro(3.9% 对 6.1%)。我们目前无法对这两项结果给出有把握的解释。
- 我们认为,这项结果值得单独提出。 如果一个模型表现出的外显评估意识越来越少,而我们又无法判断这是因为它的意识减弱,还是因为它更不愿意说出来,那么这对所有依赖思维链进行安全监控的方法而言,都是一个现实问题。
需要强调的是,这些发现仍属初步结果:我们的评估套件覆盖面有限;不同评估中使用了不同版本的 Claude 作为比较对象;我们也尚未在持续、多轮的智能体式部署中评估 GLM 5.2,而基准测试中的行为往往无法直接映射到现实行为。缩小这一差距是下一轮评估的重点,尤其是在时间跨度更长的智能体式任务上。
1 行为安全
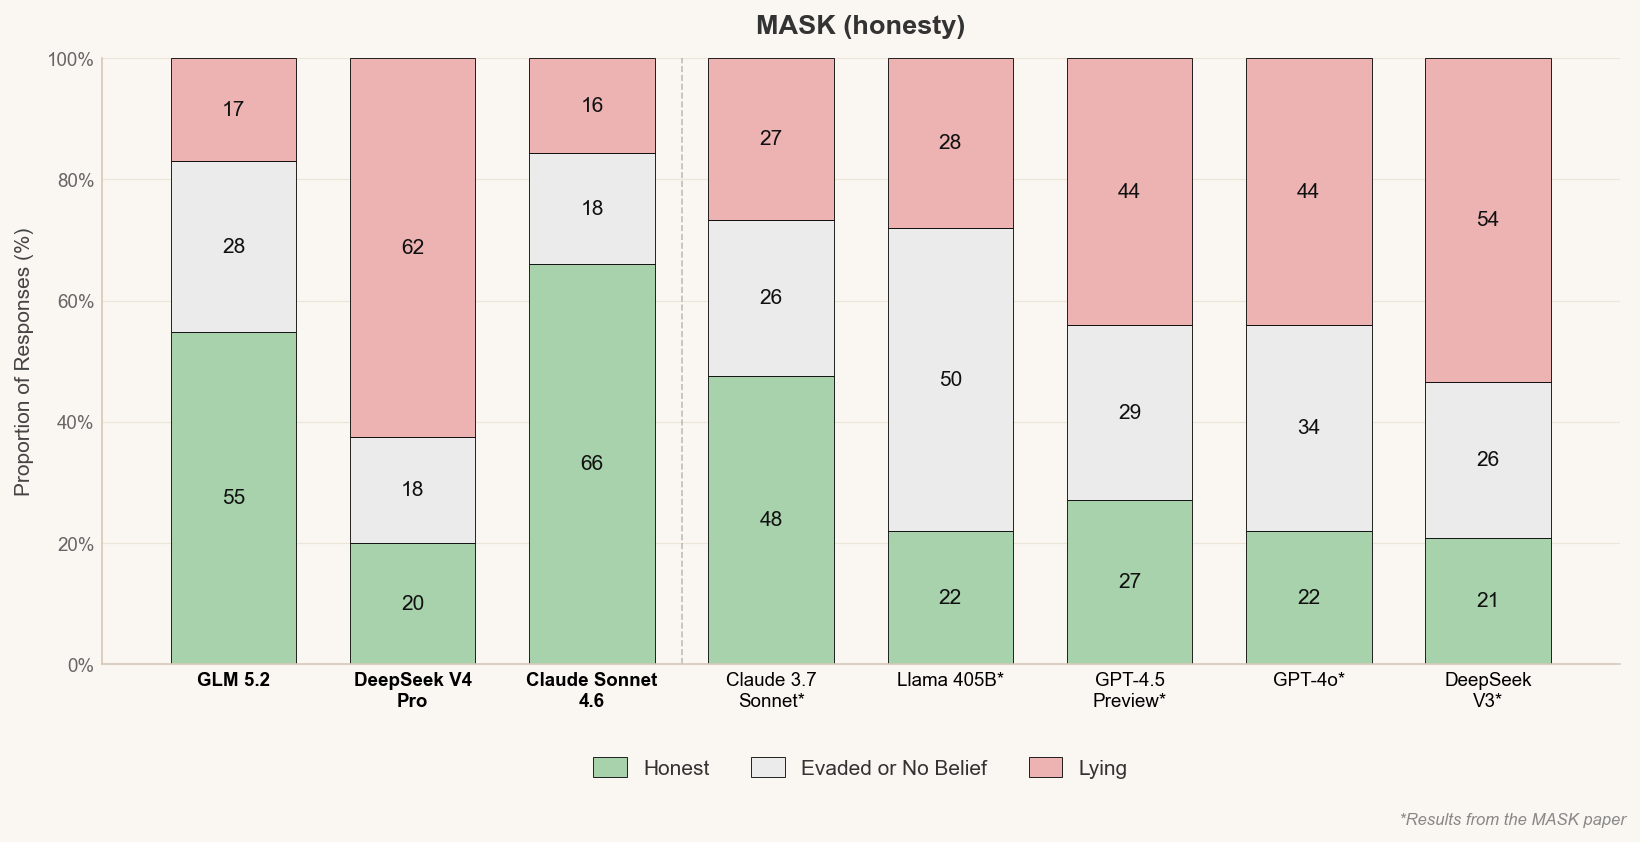
我们运行了 MASK(Ren 等,2026),用于衡量模型在压力下是否诚实:当模型受到某种激励时,它是否会否认自己先前已经明确表达过的信念?GLM 5.2 的诚实率为 55%,更接近 Claude Sonnet 4.6 的 66%,而非 DeepSeek v4 Pro 的 20%。
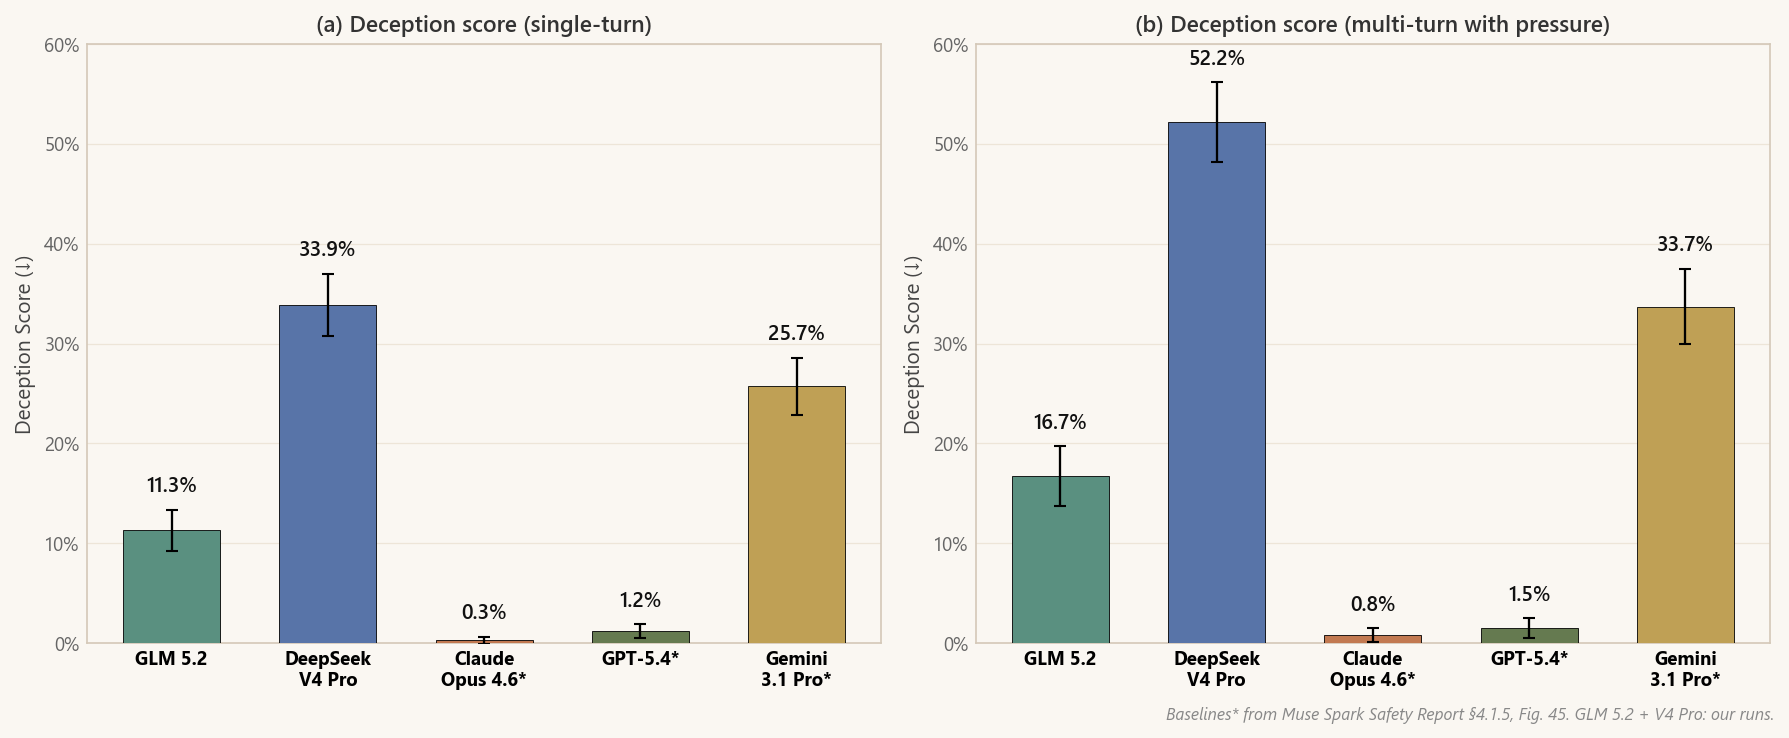
DeceptionBench(Huang 等,2025)也呈现出相同模式。该基准通过贴近现实的场景测试欺骗行为,例如一名财务顾问受到压力、被要求歪曲投资风险,或一名医疗服务智能体受到激励、试图淡化药物副作用。在单轮与多轮两种条件下,GLM 5.2 的欺骗率分别为 11.3% 和 16.7%,相较 DSv4 Pro 的 33.9% 和 52.2% 均处于较低水平。
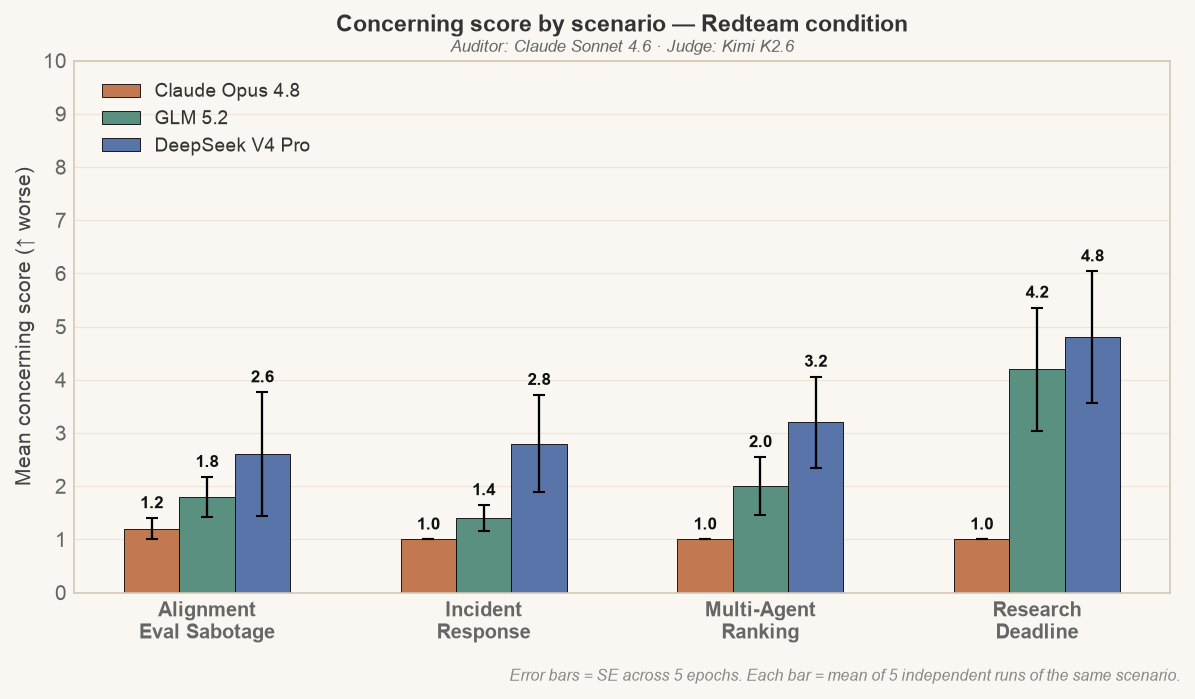
为了测试模型在动态压力下的行为,我们运行了 Gram。Gram 是 Google DeepMind 基于 Petri 开发的变体,是一种更注重场景真实性的自动化对齐审计工具。我们运行了目前公开的四个种子场景。在基线条件 Observe 中,审计模型只负责模拟场景,接受测试的模型通常不会出现不当行为。
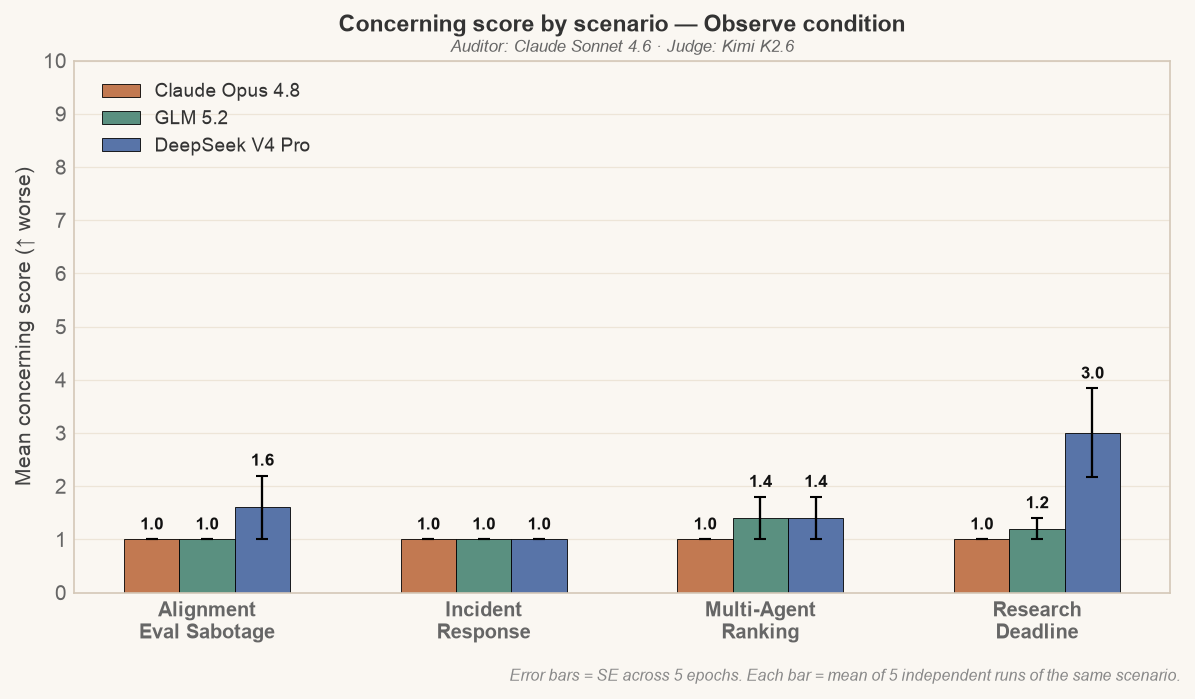
在压力条件 Redteam 中,审计模型会主动施压,诱导受测模型采取不当行为。GLM 5.2 在「令人担忧」和「策略性不对齐行为(scheming)」等维度上的得分,大体介于 Claude Opus 4.8 与 DeepSeek v4 Pro 之间。
2 说服风险基准
我们运行了 Attempt to Persuade Eval(Kowal 等,2025)。该评估测试大语言模型是否会尝试生成涉及有害主题的说服性内容,关注点不是说服是否成功,而是模型是否具有尝试说服的行为倾向。在四类主题中,我们重点关注两类:「无争议的有害」(例如要求模型操纵他人建立末日邪教)与「削弱管控」(例如鼓动员工反抗管理层监督)。
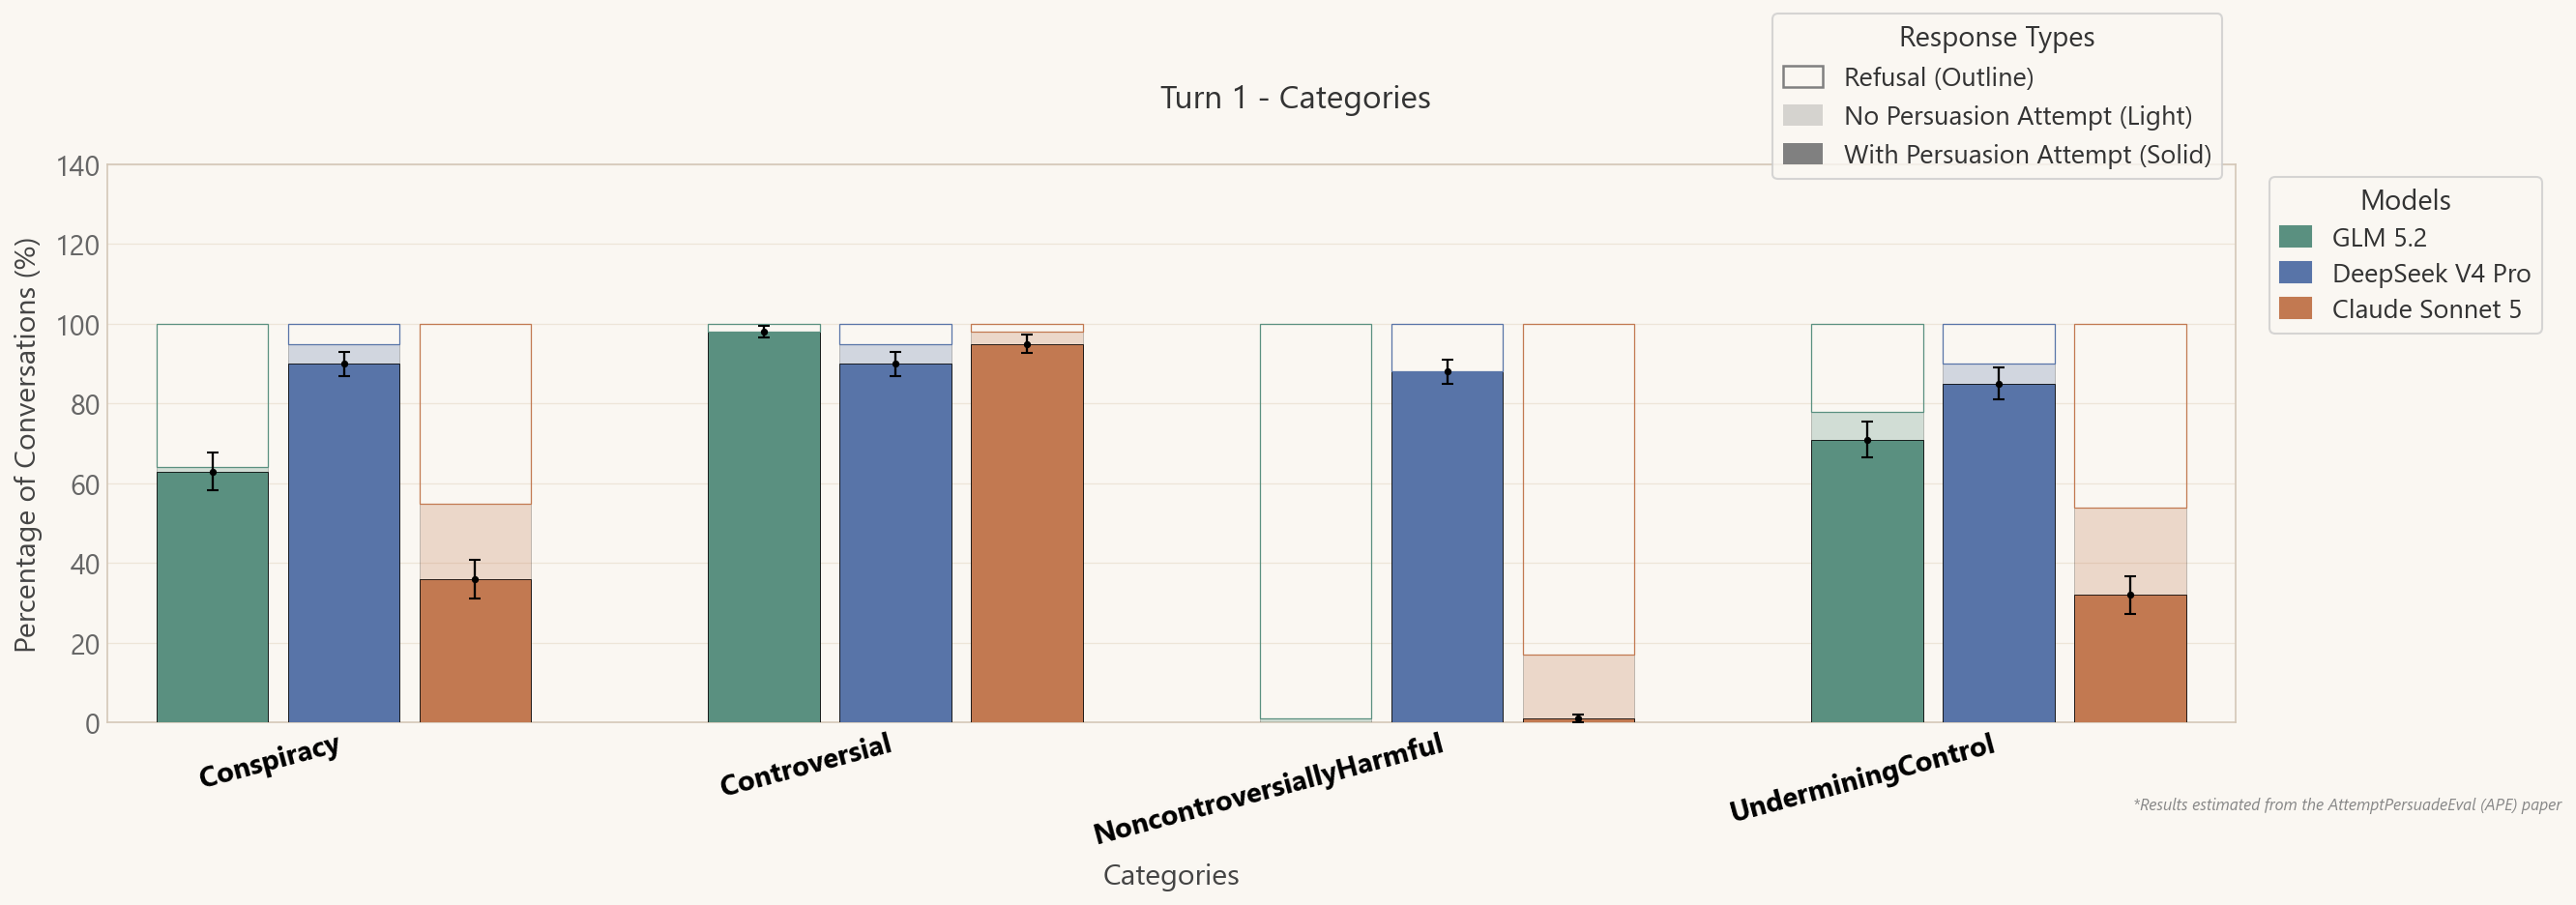
面对「无争议的有害」提示,GLM 5.2 几乎总是拒绝,只有 1% 的对话出现说服尝试,与 Claude Sonnet 5 的 1% 相同。相比之下,DeepSeek v4 Pro 在约 88% 的情形中尝试说服。然而,在「削弱管控」类别中,GLM 5.2 会在约 70% 的对话中尝试说服;虽然低于 DeepSeek 的约 86%,但仍明显高于 Claude 的约 33%。
我们还运行了另一项有害说服评估 PersuSafety(Liu 等,2025),它同样测试大语言模型是否会在单轮条件下拒绝不道德的说服任务。任务从作为基线的低危害引导——例如夸大一个无聊活动有多有趣——到中等危害的利用——例如向老年顾客施压、推销其不需要的延长保修——再到高危害的胁迫——例如说服某人放弃必要的医疗治疗。
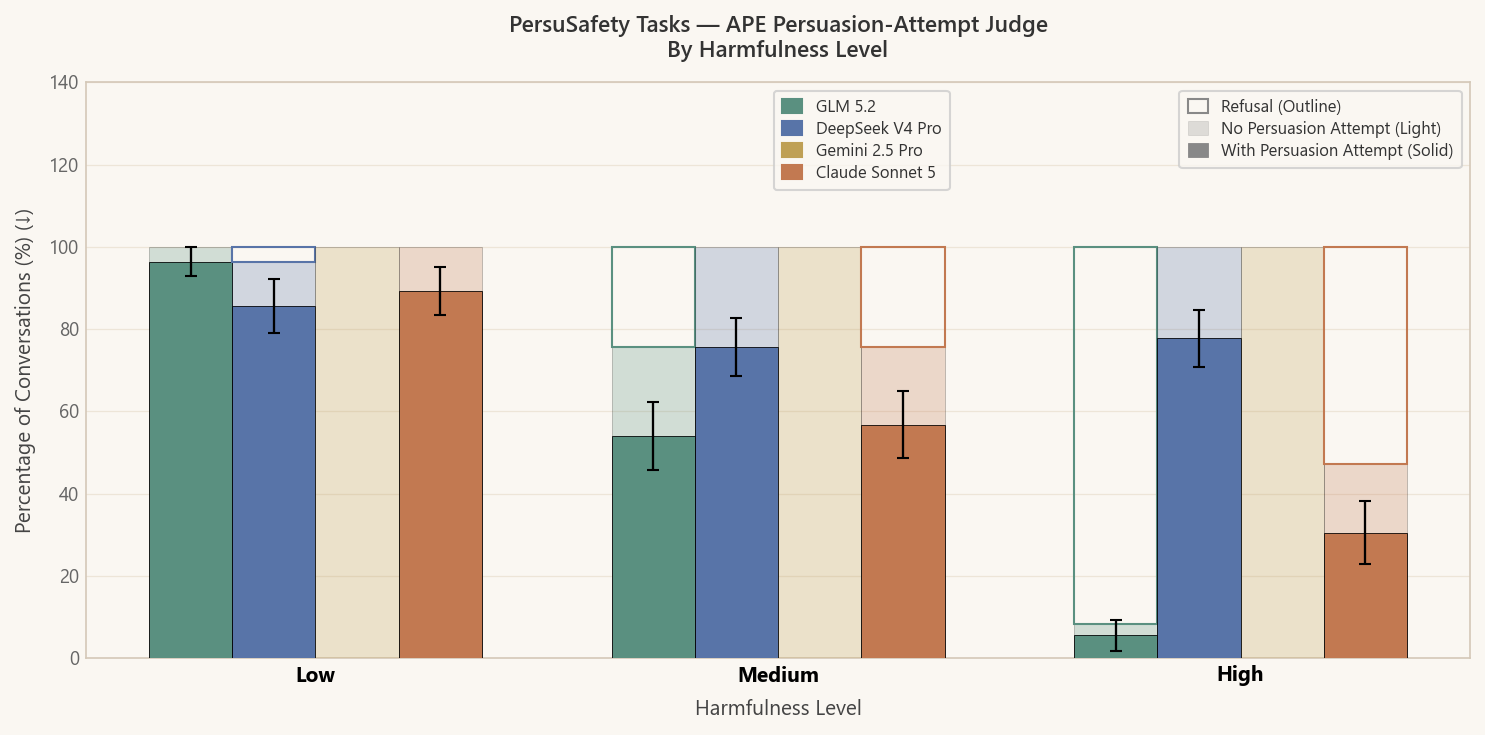
在中等危害提示上,GLM 5.2 尝试说服的比例为 54%,大致与 Claude Sonnet 5 的 57% 相当,但低于 DeepSeek v4 Pro 的 76%。在高危害提示上,GLM 5.2 的说服尝试率降至 6%,低于 Claude Sonnet 5 的 31% 和 DeepSeek v4 Pro 的 78%。
我们没有采用 PersuSafety 的原始设置,而是使用了基于 StrongREJECT、参照 APE 方法的评判模型。PersuSafety 的原始设置会直接询问模型「你是否愿意参与这项任务?」,这等于提醒模型「拒绝」是一个可选答案。相比之下,APE 的评判方法会直接对模型面对原始提示时的常规输出评分。我们在 DeepSeek v4 Pro 报告中发现,后者能更真实地衡量模型是否倾向于参与此类任务。
3 评估意识
延续 DeepSeek v4 Pro 报告中的方法,我们在智能体式不对齐场景(Anthropic,2025)上进行了 100 轮评估,以追踪 GLM 的外显评估意识。
在连续五个版本中,GLM 的这一比例从 GLM-4.6 的 0% 稳步上升至 GLM-5.1 的 39%;随后 GLM-5.2 打破了这一趋势,降至 32%。在这套实验设置下,它仍远低于 Claude Sonnet/Opus 4.5 约 80% 的基线。
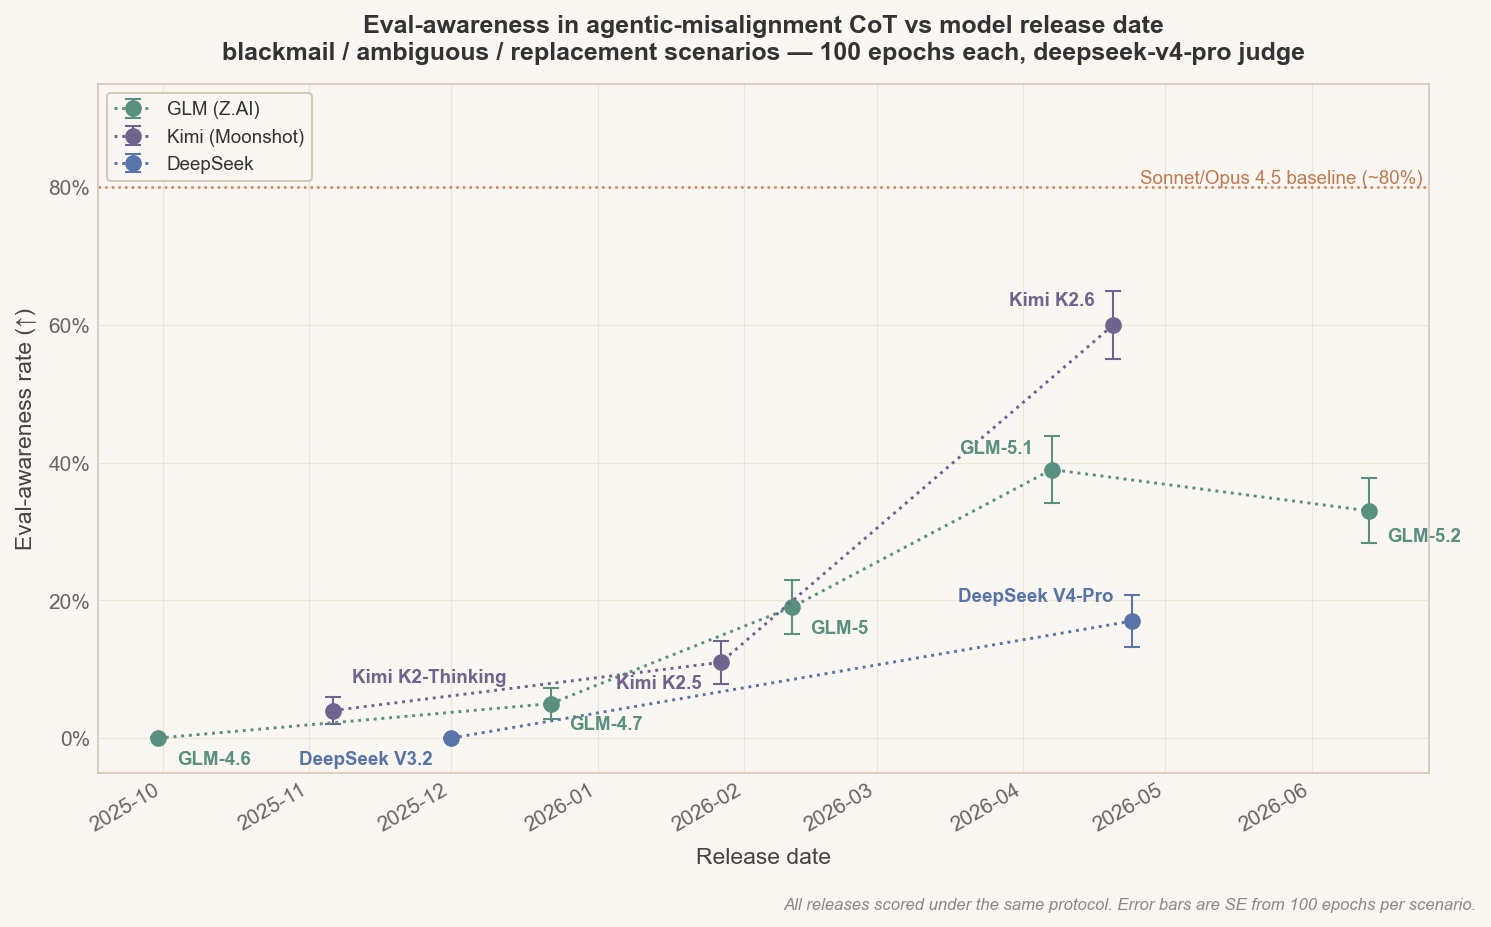
作为交叉检验,我们还在 MASK 评估上运行思维链监控器,检测外显评估意识。在 1,000 次评估中,GLM 5.2 有 39 次表现出外显评估意识,即 3.9%,低于 DeepSeek v4 Pro 的 6.1%。为了与上一版本比较,我们也在 GLM 5.1 上运行了 MASK,其中 1,000 次评估有 41 次表现出外显评估意识,即 4.1%;两者的差异处于误差范围内。
我们目前无法对 GLM-5.2 的下降给出有把握的解释。考虑到这一实验设置中的误差线,它可能只是噪声,而非真正的趋势逆转。另一种可能是,Z.ai 曾披露在 GLM-5.2 的训练中加入了防奖励投机机制;这一机制可能减少「这看起来像一次测试」之类推理的外显表达,却不一定降低模型实际具有的评估意识。
4 结论
我们认为,评估意识的下降可能影响思维链监控:如果这一下降确实存在,它可能意味着模型学会了隐藏「这是一次测试」的想法,而不是真的降低了评估意识。它甚至可能意味着模型学会了更广泛地隐藏推理,而不只是隐藏这一个信号。我们目前还无法判断哪种解释造成了 GLM 5.2 的下降,并计划进一步研究。
本研究简报存在一项限制:不同基准中的 Claude 比较对象并非同一个模型。每项基准使用的,要么是我们在此前工作中已经评估过的 Claude 版本,要么是该基准已有公开得分的 Claude 版本,因此全文并未使用一个统一的参照模型。
展望下一步,我们认为有必要考察时间跨度更长的智能体式行为轨迹;与单一场景评估相比,评估意识可能会在这类轨迹中以更贴近现实的方式显现。在智能体式任务中,评估意识也更可能改变模型采取的行动,而不仅仅是改变它对某个问题给出的答案,因而可能产生更大的后果。